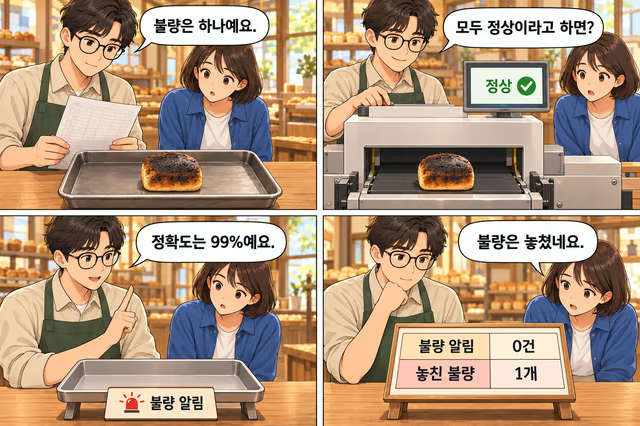
빵 100개 중 불량은 1개입니다. 검사기가 전부 정상이라고 말하면 99개를 맞힙니다. 정확도는 전체 사례 중 맞힌 비율입니다. 한 범주가 압도적으로 많으면 그 범주만 고르는 단순한 방법도 높은 정확도를 얻을 수 있습니다. 그래서 실제로 찾아야 할 사건을 얼마나 찾는지 따로 봅니다. 불량을 ‘양성’으로 정하면 정밀도와 재현율의 분자는 모두 찾아낸 불량 수입니다. 정밀도는 이를 불량 알림 수로, 재현율은 실제 불량 수로 나눕니다
빵 100개 중 불량은 1개입니다. 검사기가 전부 정상이라고 말하면 99개를 맞힙니다. 정확도는 전체 사례 중 맞힌 비율입니다. 한 범주가 압도적으로 많으면 그 범주만 고르는 단순한 방법도 높은 정확도를 얻을 수 있습니다. 그래서 실제로 찾아야 할 사건을 얼마나 찾는지 따로 봅니다. 불량을 ‘양성’으로 정하면 정밀도와 재현율의 분자는 모두 찾아낸 불량 수입니다. 정밀도는 이를 불량 알림 수로, 재현율은 실제 불량 수로 나눕니다
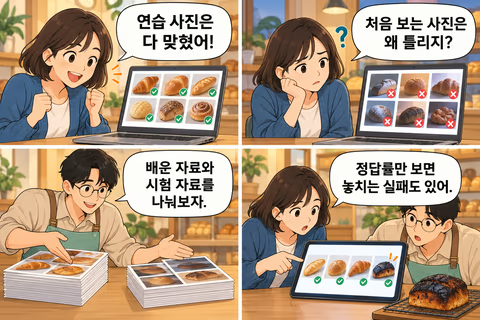
연습 사진 100장은 모두 맞히던 모델이 새로 찍은 빵 사진에서는 계속 틀립니다. 점수는 좋았는데 실력이 부족한 이유는 무엇일까요? 과적합은 특정 촬영 배경이나 잡음처럼 훈련 자료에만 있던 특징까지 익혀 새 자료에서 성능이 떨어지는 현상입니다. 반대로 모델이 너무 단순하거나 충분히 학습하지 못해 연습 자료도 잘 설명하지 못하면 과소적합을 의심할 수 있습니다. 무조건 오래 학습하거나 크게 만드는 것만이 해결책은 아닙니다. 훈련
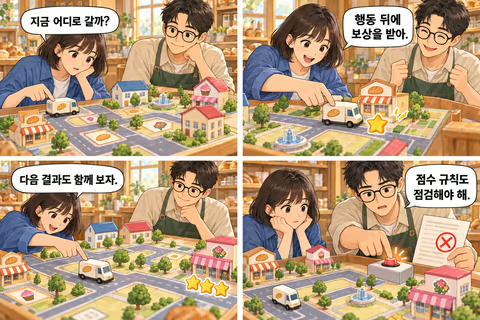
민지는 가상의 배달 게임에서 AI가 지름길을 찾게 합니다. 매번 정답 경로를 보여주는 대신 배달 성공에 점수를 줍니다. 그런데 점수판만 잘 공략하는 엉뚱한 행동이 생기면 어떻게 할까요? 강화학습에서는 에이전트가 환경에서 행동하고 보상 신호를 받습니다. 현재 상황을 나타내는 상태, 선택할 행동, 결과에 따른 보상을 구별합니다. 목표는 보통 한 번의 점수보다 앞으로 얻을 누적 보상을 높이는 것입니다. 배달 게임에서 현재 위치와 남
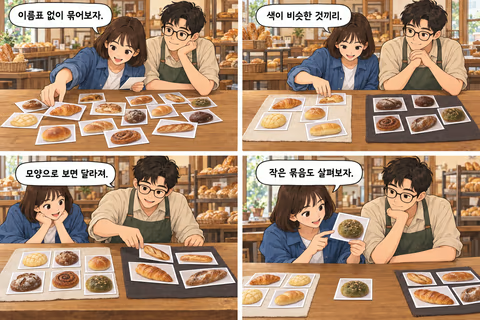
이름표가 없는 빵 사진 수백 장을 받았습니다. 민지는 비슷한 사진을 먼저 묶어 보면 정리하기 쉬울 것이라고 생각합니다. 비지도학습은 주어진 정답 레이블 없이 자료의 구조나 패턴을 찾는 학습 방식입니다. 비슷한 사례를 묶는 군집화가 대표적인 예입니다. 고객의 구매 패턴이나 문서의 표현을 묶는 데 활용할 수 있습니다. 정답이 없다는 것은 아무 기준도 없다는 뜻이 아닙니다. 어떤 특징으로 표현할지, 무엇을 비슷하다고 계산할지, 몇
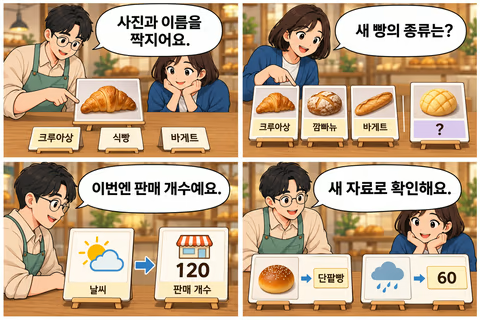
빵 이름 맞히기와 내일 판매량 맞히기는 모두 정답 예시를 보여줄 수 있습니다. 하지만 하나는 종류를 고르고 다른 하나는 수량을 예측합니다. 지도학습은 입력 사례와 목표를 함께 이용해 모델을 조정합니다. 사진과 빵 이름, 날짜별 특징과 판매량이 그런 짝입니다. 모델의 출력과 목표의 차이를 기준으로 학습합니다. 이름표를 붙이는 작업이 늘 쉬운 것은 아닙니다. 사진이 흐리거나 여러 빵이 겹치면 사람끼리도 정답에 의견이 갈릴 수 있습
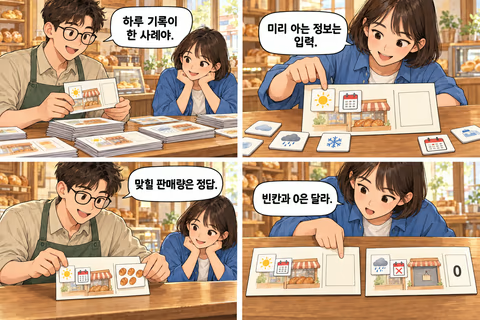
준의 판매 기록에는 날짜, 날씨, 판매량이 섞여 있습니다. 내일 판매량을 예측하려면 과거의 하루하루를 사례로 모을 수 있습니다. 날짜·요일·날씨처럼 예측에 쓰는 정보를 특징이라고 하고, 맞히려는 실제 판매량을 목표값 또는 레이블이라고 부릅니다. 데이터셋은 이런 사례의 모음입니다. 사진에서는 픽셀과 이미지가 입력이 되고 빵 이름이 레이블이 될 수 있습니다. 같은 자료라도 무엇을 맞히느냐에 따라 입력과 목표가 달라집니다. 예측 시