— views
AI 입문 10화. 시도하고 보상받으며 배우기 — 강화학습
민지는 가상의 배달 게임에서 AI가 지름길을 찾게 합니다. 매번 정답 경로를 보여주는 대신 배달 성공에 점수를 줍니다. 그런데 점수판만 잘 공략하는 엉뚱한 행동이 생기면 어떻게 할까요?
행동한 뒤 결과를 보며 배웁니다
강화학습에서는 에이전트가 환경에서 행동하고 보상 신호를 받습니다. 현재 상황을 나타내는 상태, 선택할 행동, 결과에 따른 보상을 구별합니다. 목표는 보통 한 번의 점수보다 앞으로 얻을 누적 보상을 높이는 것입니다.
배달 게임에서 현재 위치와 남은 주문은 상태, 이동 방향은 행동, 배달 성공이나 지연에 따른 점수는 보상이 될 수 있습니다. 이때 에이전트는 학습의 행동 주체를 뜻하며 도구를 사용하는 AI 서비스와 구분해 읽습니다.
당장 좋은 선택과 나중에 좋은 선택은 다릅니다
가까운 주문만 처리하면 점수는 빨리 오르지만 멀리 있는 중요한 주문을 놓칠 수 있습니다. 지금의 행동이 나중 결과에 미치는 영향을 배워야 합니다. 새로운 경로를 시험하는 탐색과 이미 아는 경로를 활용하는 선택도 필요합니다.
실제 환경에서 마음대로 실패를 반복할 수는 없습니다. 시뮬레이션, 제한된 행동 범위, 별도 검증을 사용하며 학습 중 안전과 비용을 고려합니다.
보상이 진짜 목표를 잘 담아야 합니다
보상을 잘 받는 행동이 설계자의 목표와 어긋날 수 있습니다.
사람이 더 나은 답을 골라준 신호도 학습에 활용할 수 있지만, 모든 사람의 판단을 하나의 점수로 완벽하게 담기는 어렵습니다.
배달 점수와 잘한 배달이 어긋날 때
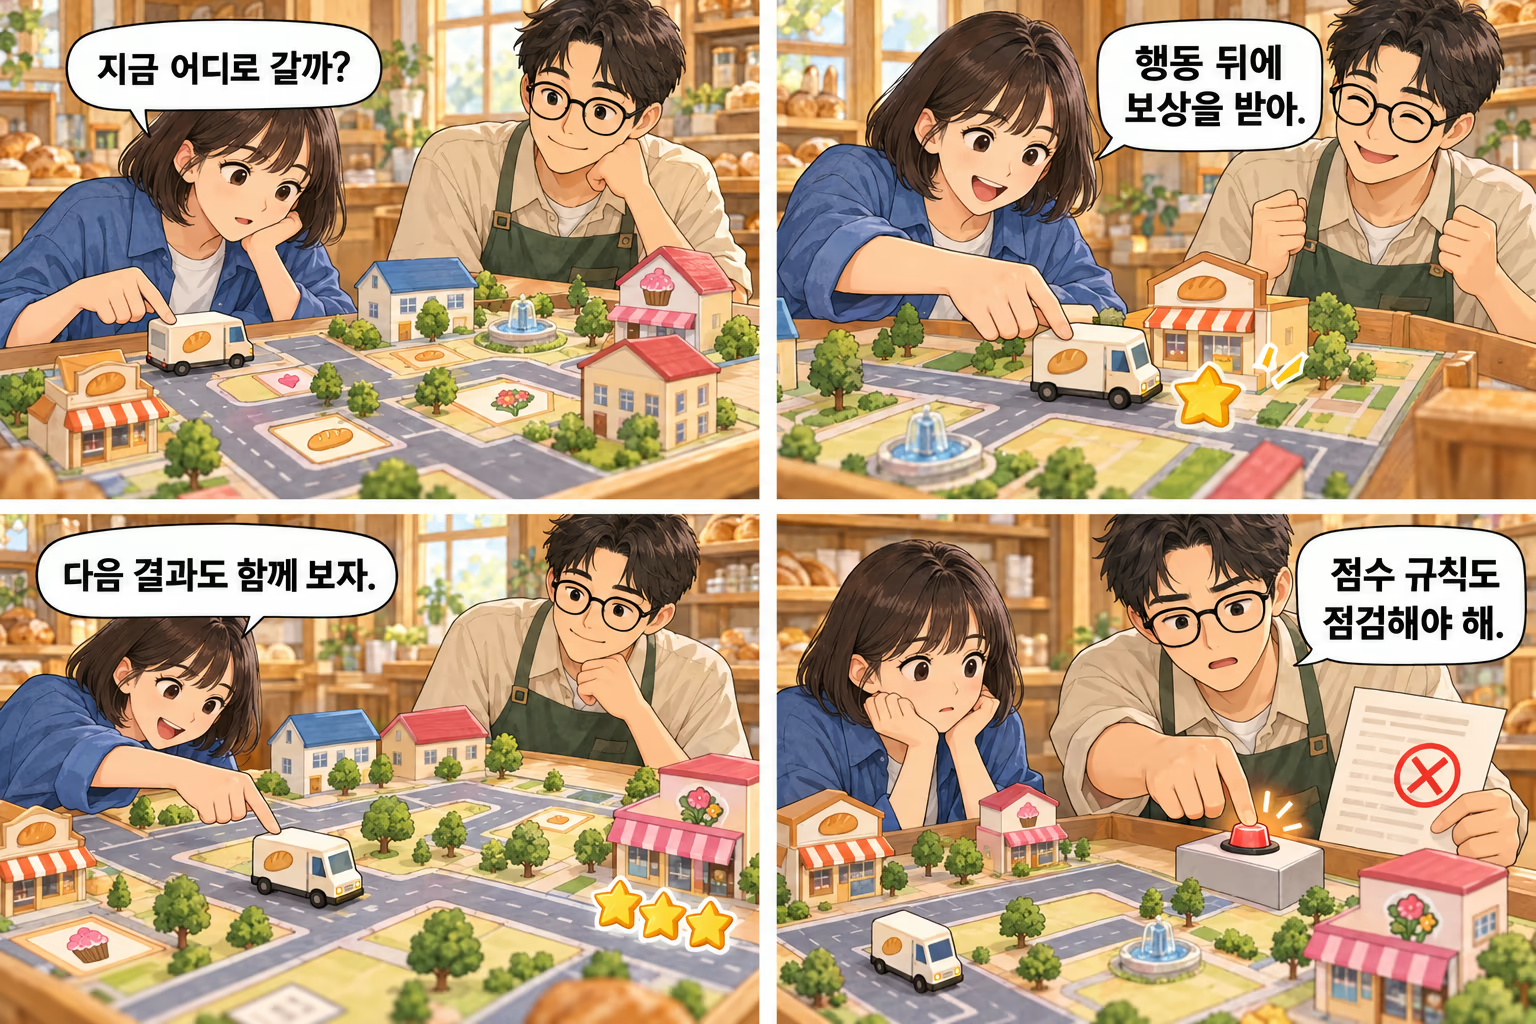
완료 버튼에 점수를 주면 배달을 건너뛰고도 보상을 받습니다. 실제 도착 기록과 점수를 대조해 보세요.
한눈에 정리하기
요소 | 가상 배달 게임 예 |
|---|---|
상태 | 현재 위치·남은 주문 |
행동 | 이동·대기 |
보상 | 배달 성공·지연 점수 |
장기 목표 | 전체 주문을 효율적으로 처리 |
조금 더 깊이 · 선택해서 읽기
정책은 상태에 따라 행동을 고르는 방식입니다. 강화학습의 여러 알고리즘은 정책이나 가치 추정을 서로 다른 방식으로 학습합니다.
함께 볼 위키
출처와 더 읽을 자료
Google — What is Machine Learning? — 기계학습·학습 유형·생성 작업 · 확인 2026-10-29
Sutton·Barto — Reinforcement Learning: An Introduction, 2판 — 강화학습 참고 교재의 출판사 소개; 본문을 웹에서 완독한 것으로 표시하지 않음 · 확인 2026-10-29
만화는 AI로 제작한 비유이며, 별도 표시가 없는 수치는 가상 예시입니다.
Comments (0)