— views
AI 입문 14화. 층을 쌓으면 무엇이 달라질까? — 딥러닝
작은 계산기를 여러 개 이어 붙이면 무엇이 달라질까요? 민지는 같은 덧셈을 반복하는 것뿐이라면 큰 차이가 없을 것 같다고 말합니다.
층은 입력 표현을 차례로 바꿉니다
입력층은 자료를 받고, 중간의 은닉층은 표현을 변환하며, 출력층은 문제에 필요한 결과를 만듭니다. 은닉층은 비밀스럽게 생각하는 공간이 아니라 입력·출력 사이의 계산 단계입니다.
사진에서 단순한 패턴을 결합해 복잡한 형태를 구별하는 직관을 떠올릴 수 있습니다. 다만 모든 모델의 각 층에 '눈 담당·코 담당'처럼 고정된 의미가 붙는 것은 아닙니다.
활성화 함수가 비선형 변환을 넣습니다
가중합 같은 선형·아핀 변환만 여러 번 이어 붙이면 전체도 하나의 같은 종류 변환으로 합칠 수 있습니다. 층을 쌓는 것만으로 표현력이 원하는 만큼 늘어나지 않는 이유입니다.
활성화 함수의 비선형 변환 덕분에 여러 층을 조합해 직선 하나로 나타내기 어려운 패턴도 표현할 수 있습니다.
깊이가 많으면 학습과 운영도 복잡해집니다
여러 층은 풍부한 표현을 만들 가능성을 주지만 계산량과 메모리 사용도 늘어납니다. 학습이 불안정해지거나 자료에 과도하게 맞출 수도 있습니다.
'딥러닝'을 깊은 철학적 사고라는 뜻으로 읽지 않습니다. 오늘의 목표는 여러 계산 단계와 비선형 변환이 어떻게 역할을 나누는지 이해하는 것입니다.
중간의 작은 규칙이 계산의 모양을 바꿉니다
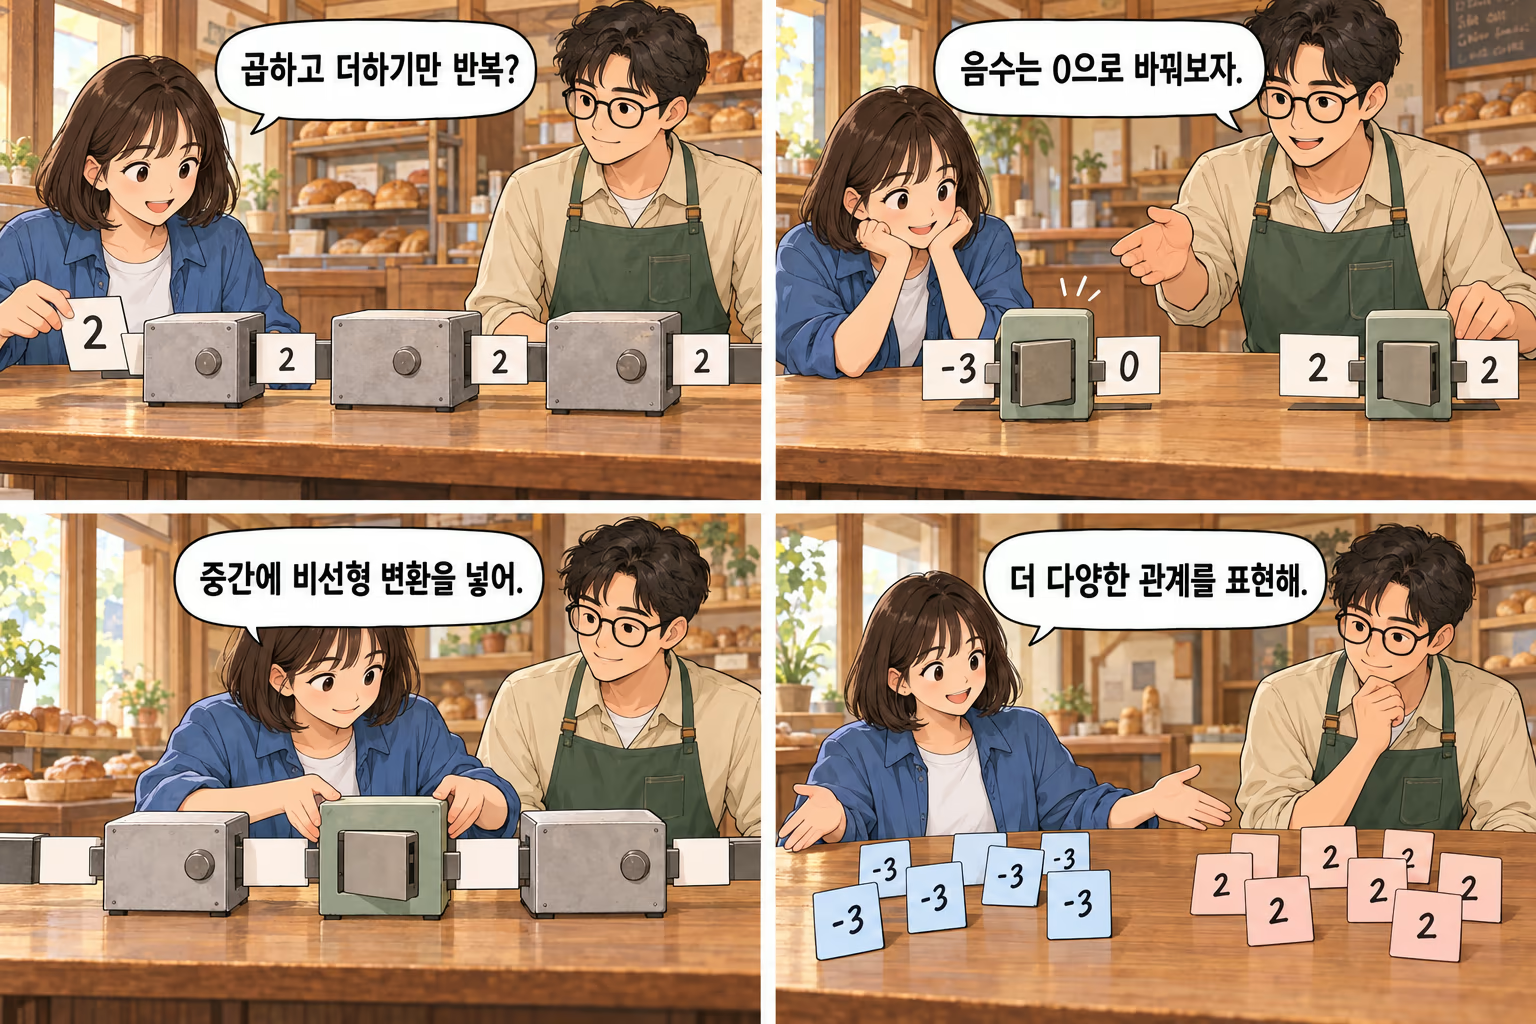
ReLU는 −3을 0으로 바꾸고 2는 그대로 둡니다. 비선형 변환 없이 선형 층만 쌓으면 하나의 선형 변환으로 합칠 수 있습니다.
한눈에 정리하기
입력 | ReLU 출력 |
|---|---|
-3 | 0 |
0 | 0 |
2 | 2 |
확인 문제
ReLU에 −5와 4를 차례로 넣으면 출력은?
① 0과 4
② 5와 4
정답과 해설
정답 ① 0과 4 · ReLU는 입력과 0 중 큰 값을 남긴다. 음수의 부호를 뒤집는 함수와 다르다.
조금 더 깊이 · 선택해서 읽기
실제 언어 모델에서는 GELU나 SiLU 계열 등 다양한 활성화와 게이트 구조를 사용합니다. 특정 활성화 하나가 모든 신경망에 공통인 것은 아닙니다.
함께 볼 위키
출처와 더 읽을 자료
Google — Nodes and hidden layers — 노드·가중치·은닉층 · 확인 2026-10-29
Google — Activation functions — 선형 연산의 합성과 비선형 활성화 · 확인 2026-10-29
만화는 AI로 제작한 비유이며, 별도 표시가 없는 수치는 가상 예시입니다.
Comments (0)