— views
AI 입문 20화. AI는 문장을 글자 그대로 읽을까? — 토큰
문장을 단어 수로 세는 사람과 토큰으로 처리하는 모델은 같은 경계를 사용하지 않을 수 있습니다.
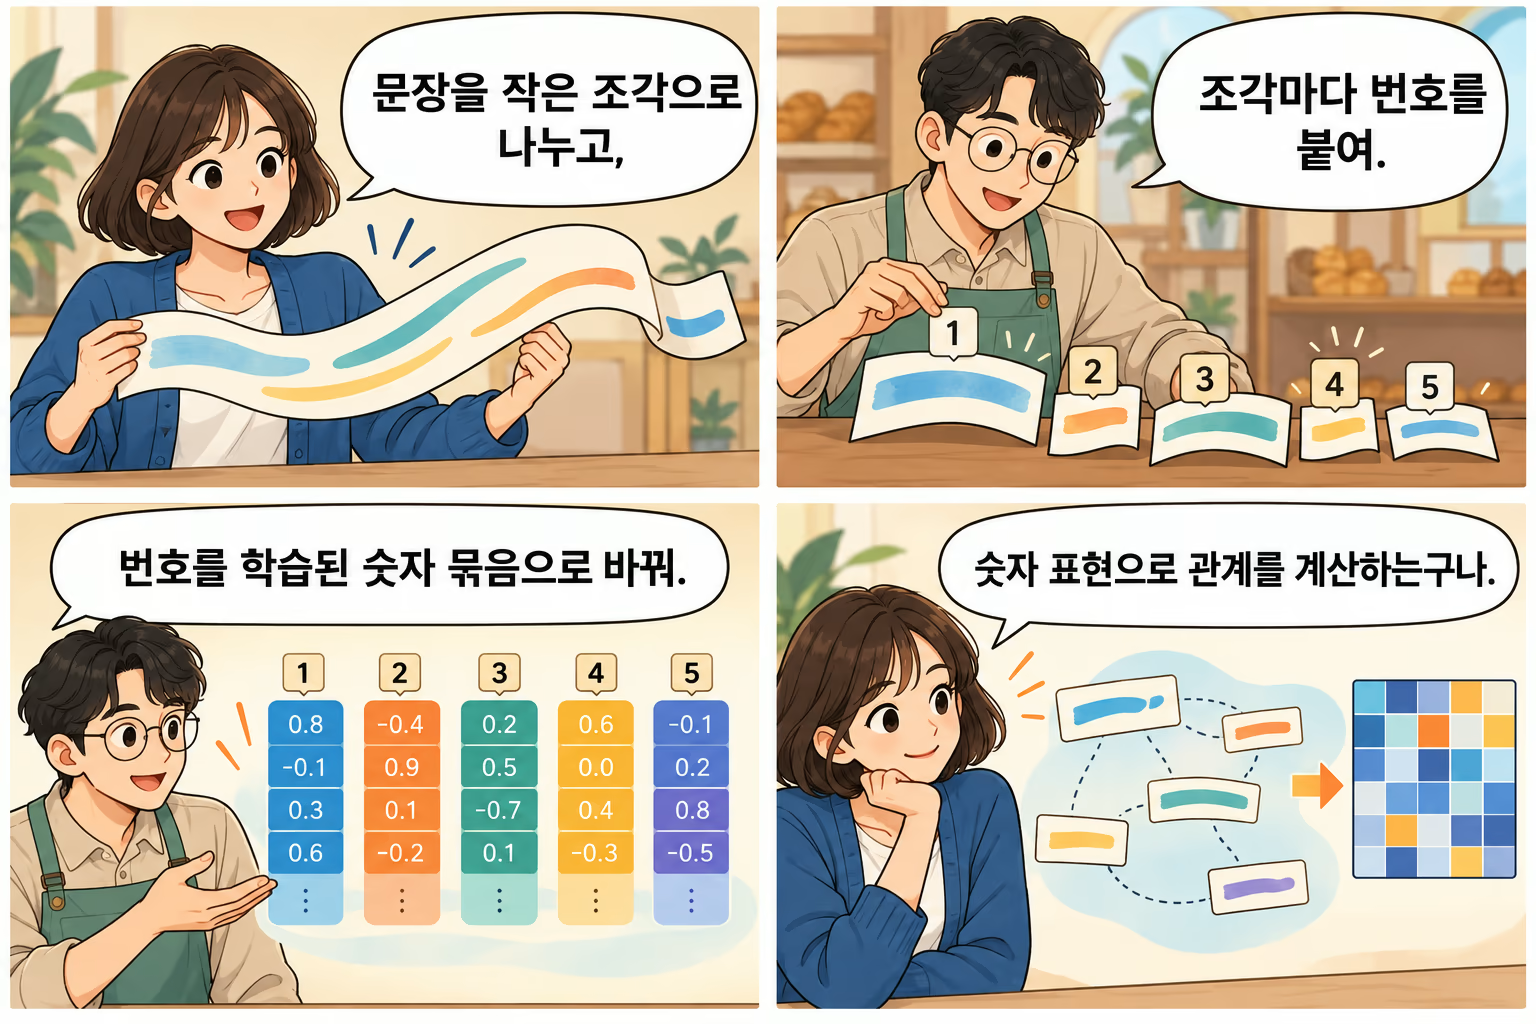
토큰은 처리에 사용하는 텍스트 단위입니다
토큰은 문자 하나, 단어 전체, 단어의 일부, 공백을 포함한 조각 등 여러 형태일 수 있습니다. 어떤 조각을 쓰는지는 토크나이저에 따라 달라집니다. 한국어 한 단어가 언제나 한 토큰인 것은 아닙니다.
예를 들어 '학교에서'를 '학교'와 '에서'로 나누는 모습을 상상할 수 있지만, 이는 설명용 분할입니다. 특정 모델이 실제로 그렇게 나누는지는 해당 토크나이저로 확인해야 합니다.
조각에 번호를 붙입니다
토크나이저는 텍스트를 사전 항목을 가리키는 토큰 ID의 열로 바꿉니다.
대화의 시작·종료·역할 등을 표현하는 특수 토큰도 사용할 수 있습니다. 화면에 보이는 문장 외에 서비스가 붙이는 형식 정보가 모델 입력에 포함될 수 있습니다.
길이와 잘리는 위치에 영향을 줍니다
모델이 한 번에 처리할 수 있는 문맥 길이는 보통 토큰 수로 제한합니다. 같은 글자 수라도 언어·표기·토크나이저에 따라 토큰 수가 달라집니다. 입력과 출력, 내부 형식에 배정되는 공간도 고려해야 합니다.
토큰으로 바꾼 뒤에는 번호를 숫자 벡터로 표현해 신경망에 전달합니다. 임베딩은 토큰 번호를 계산에 쓸 벡터로 바꿉니다.
조각의 번호와 의미의 표현은 다른 단계입니다
토큰 ID는 도서관 관리번호와 같습니다. 번호가 이웃해도 뜻이 비슷하지는 않습니다. 계산은 ID에 대응하는 임베딩 벡터에서 시작합니다.
한눈에 정리하기
표현 | 뜻 |
|---|---|
글자 수 | 문자 기준 길이 |
단어 수 | 단어 경계 기준 길이 |
토큰 수 | 토크나이저의 조각 기준 길이 |
토큰 ID | 해당 조각을 가리키는 번호 |
조금 더 깊이 · 선택해서 읽기
BPE·WordPiece·Unigram 등 토큰화 접근이 있습니다. 어휘 구성과 정규화 방식도 결과에 영향을 줍니다. 이 시리즈의 조각 카드는 실제 토크나이저 출력으로 표시하지 않는 한 설명용입니다.
함께 볼 위키
출처와 더 읽을 자료
Hugging Face — Tokenizers — 텍스트 분할과 ID 변환 · 확인 2026-10-29
Hugging Face — Causal language modeling — 미래를 가리는 다음 토큰 예측 · 확인 2026-10-29
만화는 AI로 제작한 비유이며, 별도 표시가 없는 수치는 가상 예시입니다.
Comments (0)