— views
AI 입문 21화. 단어에 숫자 주소를 붙인다 — 임베딩
토큰 번호만으로는 '빵'과 '식빵'이 어떤 관계인지 표현하기 어렵습니다. 임베딩은 대상을 계산 가능한 숫자 묶음으로 표현하는 방법입니다.
번호에서 숫자 벡터로 바꿉니다
토큰 임베딩은 각 토큰 ID에 대응하는 벡터를 사용합니다. 벡터는 여러 숫자를 순서대로 모은 것입니다. 간단한 설명에서는 2~3개 좌표로 그릴 수 있지만 실제 모델의 표현은 훨씬 많은 차원을 가질 수 있습니다.
학습을 통해 표현이 조정되면 작업에 필요한 관계를 숫자 계산으로 다룰 수 있습니다. 토큰 외에도 문장·이미지·사용자·상품을 임베딩으로 표현하는 방법이 있습니다.
가까움은 학습 목표와 계산 기준에 달려 있습니다
식빵과 바게트의 벡터가 얼마나 가깝게 놓일지는 학습 자료와 목표에 따라 달라집니다.
각 축이 맛·가격·색처럼 사람이 쉽게 이름 붙일 수 있는 속성이라고 단정하지 않습니다. 한 가지 의미가 여러 좌표에 분산될 수도 있습니다. 이런 단순한 비유와 내부 표현의 실제 구조를 구별해야 합니다.
초기 임베딩과 문맥을 거친 표현은 다릅니다
같은 토큰 ID는 보통 같은 초기 임베딩을 가져옵니다. 이후 신경망 층을 거치면 주변 토큰에 따라 표현이 달라질 수 있습니다. '배를 먹었다'와 '배를 탔다'의 차이는 문맥을 처리하는 과정에서 중요해집니다.
검색용 문장 임베딩도 모델과 사용법에 따라 달라집니다. 숫자 벡터가 있다는 이유만으로 모든 모델의 벡터를 같은 공간에 섞어 비교할 수 있는 것은 아닙니다.
번호표에서 관계를 계산할 수 있는 표현으로
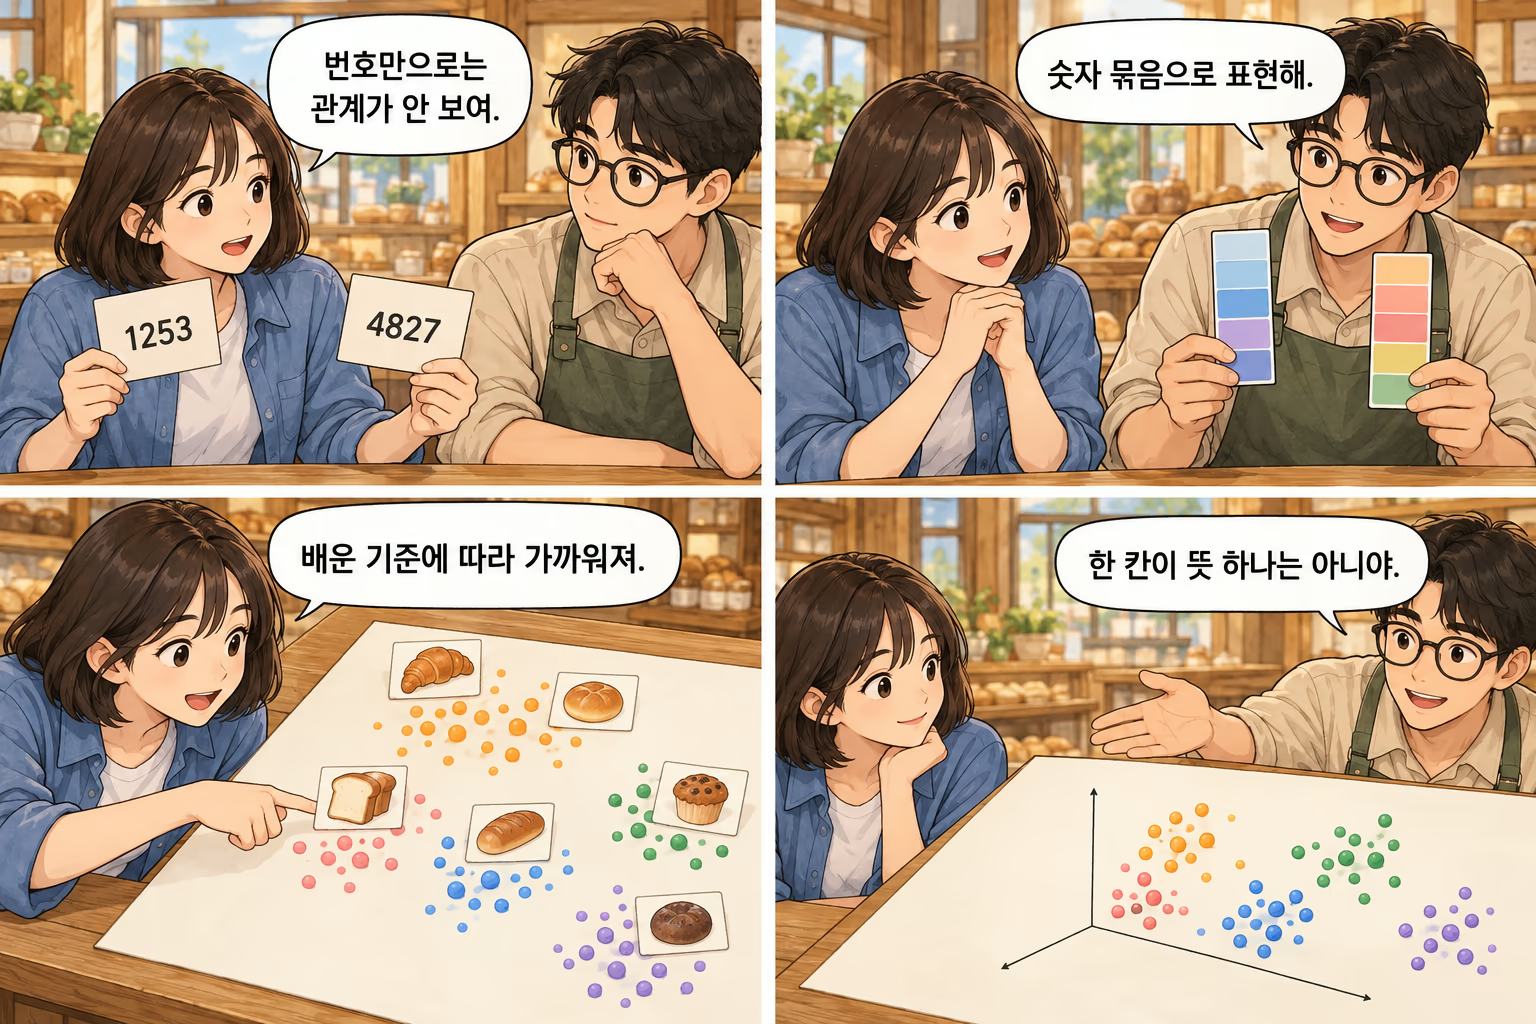
빵 지도에선 사람이 축에 ‘단맛’ 같은 이름을 붙일 수 있지만, 학습된 임베딩의 각 좌표에 그런 이름이 정해져 있지는 않습니다.
한눈에 정리하기
단계 | 역할 |
|---|---|
토큰 ID | 조각 식별 |
초기 임베딩 | 토큰을 숫자 벡터로 표현 |
문맥 처리 후 표현 | 주변 정보가 반영된 벡터 |
유사도 | 정해진 기준으로 관계 비교 |
벡터가 비슷하다고 두 문장이 같은 사실을 말하는 것은 아닙니다.
조금 더 깊이 · 선택해서 읽기
임베딩은 학습 가능한 표에서 찾아오거나 별도 인코더로 계산할 수 있습니다. 유사도에는 코사인 유사도·내적·거리 등 여러 기준을 사용합니다.
함께 볼 위키
출처와 더 읽을 자료
Google — Embeddings — 학습된 벡터 표현 · 확인 2026-10-29
Hugging Face — Tokenizers — 텍스트 분할과 ID 변환 · 확인 2026-10-29
만화는 AI로 제작한 비유이며, 별도 표시가 없는 수치는 가상 예시입니다.
Comments (0)