— views
AI 입문 32화. 아주 많은 글로 배우기 — 사전학습
같은 구조의 신경망을 만들었다고 곧바로 한국어로 대화할 수 있을까요? 계산 경로가 있어도 그 안의 수많은 값은 학습으로 정해야 합니다.
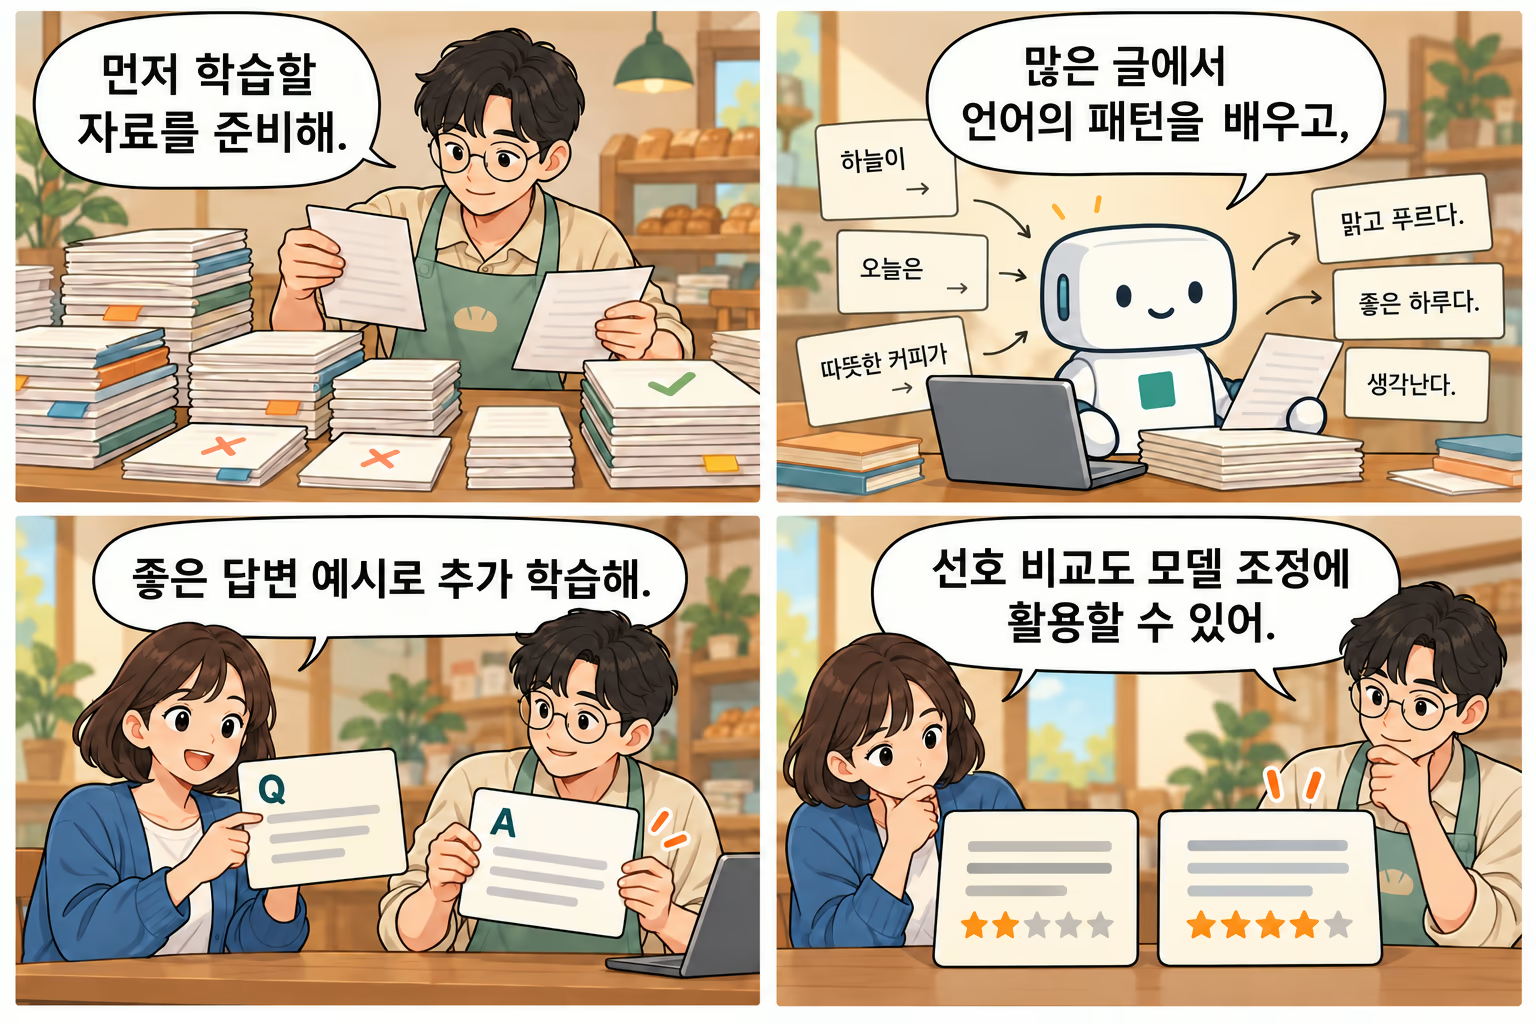
많은 예시에서 예측을 연습합니다
자기회귀 사전학습은 앞부분으로 다음 토큰을 맞히는 일을 대량으로 반복합니다. 정답은 원문에 있습니다.
예측과 목표의 차이에서 손실을 구하고, 역전파로 기울기를 계산하며, 옵티마이저로 가중치를 바꿉니다.
데이터를 준비하는 일이 중요합니다
수집한 자료를 그대로 모두 넣는 것으로 끝나지 않습니다. 중복·잡음·품질·언어 구성·사용 권한 등을 검토하고, 학습과 평가가 섞이지 않도록 관리합니다. 토큰화와 길이 조정 등 학습용 형태로 만드는 작업도 필요합니다.
인터넷의 글에는 오류와 편향도 있습니다. 많이 읽었다는 말만으로 정확하거나 공정한 모델이 되었다고 판단할 수 없습니다. 어떤 자료가 얼마나 포함되는지에 따라 배울 수 있는 패턴도 달라집니다.
문장을 통째로 저장하는 사전과는 다릅니다
학습은 매개변수를 바꾸어 여러 입력에 대응하는 패턴을 형성하는 과정입니다. 그러나 일부 훈련 내용을 기억하거나 재현하는 현상도 생길 수 있습니다. '모두 암기한다'와 '절대 암기하지 않는다'는 설명은 모두 지나칩니다.
학습 자료의 시간 범위도 지식의 완벽한 경계선은 아닙니다. 그 이전 사실을 모두 아는 것은 아니며, 이후 정보가 필요하면 문맥이나 검색 등 별도의 경로가 필요할 수 있습니다.
다음 말을 잘 잇는 능력과 좋은 대화는 다릅니다
사전학습으로 언어와 다양한 작업의 기초 능력을 얻어도 사용자의 지시를 원하는 방식으로 따르는 데는 후속 학습과 평가가 필요할 수 있습니다.
규모는 중요한 요인 중 하나이지만 모델 구조·데이터·학습 방법·평가 조건도 함께 작용합니다. 매개변수 수 하나만 보고 모든 작업의 우열을 정할 수는 없습니다.
자료 더미에서 배운 패턴과 대화 방식은 구별됩니다
앞의 두 컷은 글에서 언어 패턴을 배우는 사전학습, 뒤의 두 컷은 답변 예시와 선호 비교를 쓰는 후속 학습입니다. 어느 쪽도 오늘의 공지를 실시간으로 조회한 것은 아닙니다.
한눈에 정리하기
준비 또는 학습 | 확인할 점 |
|---|---|
자료 구성 | 품질·중복·언어·사용 조건 |
목표 만들기 | 앞 문맥과 다음 토큰 |
가중치 갱신 | 손실 → 기울기 → 갱신 |
평가 | 새로운 자료와 실제 목표에서 성능 확인 |
조금 더 깊이 · 선택해서 읽기
모델의 가중치, 토크나이저, 설정은 서로 맞아야 합니다. 같은 이름의 구조라도 어휘나 차원 등이 다르면 구성요소를 임의로 바꿔 끼울 수 없습니다.
함께 볼 위키
출처와 더 읽을 자료
Hugging Face — Causal language modeling — 미래를 가리는 다음 토큰 예측 · 확인 2026-10-29
Hugging Face LLM Course — Introduction — 언어 모델·자연어 처리 개관 · 확인 2026-10-29
Brown 외 — Language Models are Few-Shot Learners (2020) — 사전학습과 가중치 갱신 없는 문맥 예시 · 확인 2026-10-29
만화는 AI로 제작한 비유이며, 별도 표시가 없는 수치는 가상 예시입니다.
Comments (0)