— views
AI 입문 24화. 사람이 모든 문장에 정답을 달아줘야 할까?
인터넷의 모든 문장에 사람이 일일이 정답을 달아주기는 어렵습니다. 그렇다면 원래 자료의 일부를 예측 문제로 바꾸면 어떨까요?
원문을 입력과 목표로 나눕니다
다음 토큰 예측에서는 원문의 뒷부분이 정답 역할을 합니다.
다른 방식으로는 문장의 일부를 가리고 그 부분을 복원하도록 할 수 있습니다. 예를 들어 '과수원에 [빈칸]가 열렸다'에서 가린 단어를 맞히게 하는 것이 이런 마스킹 연습입니다. 다음 토큰 예측과 빈칸 복원은 같은 목적식이 아니므로 구별합니다.
많은 작은 문제에서 표현을 배웁니다
여러 자료에서 반복되는 관계를 이용해 언어의 형태와 문맥 패턴을 학습합니다. 그 결과를 다른 작업에 활용하거나 추가 학습의 출발점으로 사용할 수 있습니다.
학습 목표가 원문을 맞히는 것이므로 원문에 담긴 오류와 편향의 영향을 받을 수 있습니다. 자료가 스스로 목표를 제공한다고 품질 검토가 필요 없어지는 것은 아닙니다.
자료 준비에는 여전히 선택이 들어갑니다
어떤 자료를 포함할지, 중복을 어떻게 줄일지, 평가 자료가 학습에 섞이지 않게 어떻게 관리할지 정해야 합니다. 언어와 분야의 비중도 결과에 영향을 줍니다.
이후 좋은 답변 예시나 선호 신호로 추가 학습을 할 수 있습니다. 자기지도 사전학습과 질문에 잘 답하도록 조정하는 과정은 서로 다른 역할을 합니다.
완성된 문장에서 연습 문제를 만드는 방법
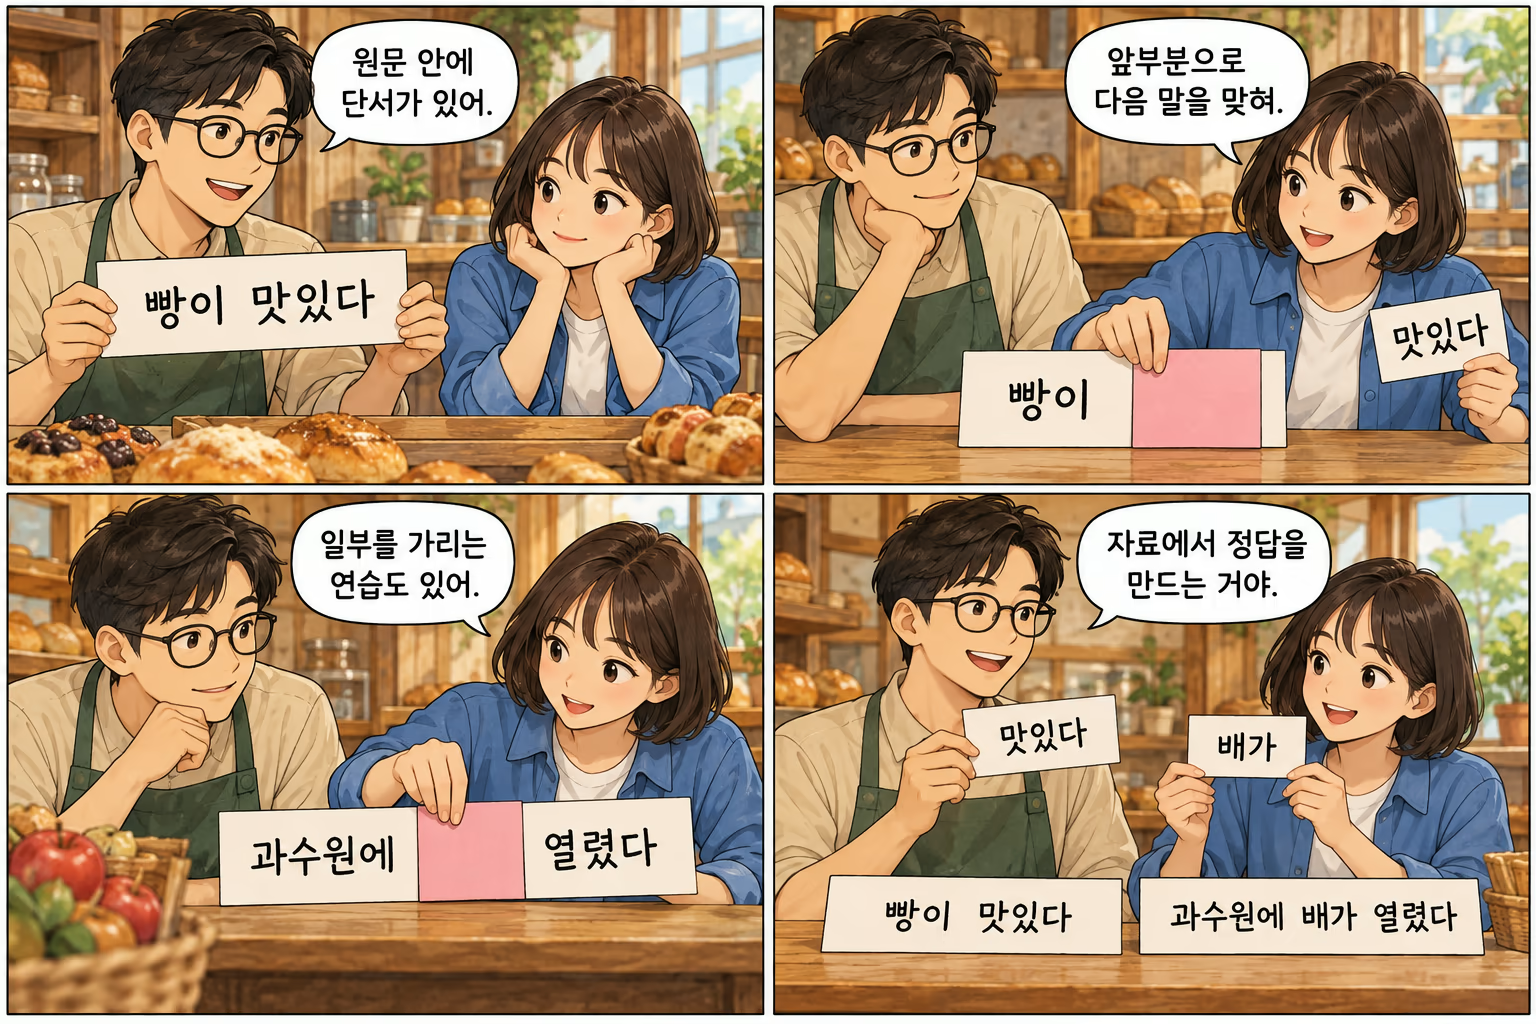
그림에서 ‘빵이’ 다음에 실제로 나온 ‘맛있다’를 목표로 삼거나, ‘과수원에 배가 열렸다’의 한 조각을 가렸다가 맞힙니다. 두 경우 모두 원문에서 정답을 얻습니다.
한눈에 정리하기
학습 문제 | 입력에 보이는 것 | 목표 |
|---|---|---|
다음 토큰 예측 | 앞선 토큰 | 실제로 이어진 토큰 |
마스킹 복원 | 빈칸을 제외한 허용 문맥 | 가려진 부분 |
공통점 | 원문에서 학습 문제 구성 | 자료 자체에서 목표 생성 |
확인 문제
같은 모델에서 같은 토큰 ID가 서로 다른 문장에 등장했다. 주변 문장에 따라 달라질 수 있는 것은?
① 임베딩 표에서 그 ID로 꺼낸 벡터
② 문맥을 처리한 뒤의 표현
정답과 해설
정답 ② 문맥을 처리한 뒤의 표현 · 고정된 표에서 같은 번호로 꺼내는 값은 같다. 이후 층에서는 주변 토큰의 정보가 섞인다.
조금 더 깊이 · 선택해서 읽기
자기지도학습은 언어 외에 이미지와 음성에서도 사용됩니다. 어떤 부분을 예측하거나 어떤 표현을 가깝게 만들지는 작업과 방법마다 다릅니다.
함께 볼 위키
출처와 더 읽을 자료
Hugging Face — How do Transformers work? — 트랜스포머 계열·사전학습·미세조정 · 확인 2026-10-29
Hugging Face — Causal language modeling — 미래를 가리는 다음 토큰 예측 · 확인 2026-10-29
Hugging Face — Masked language modeling — 가린 토큰 복원 목표 · 확인 2026-10-29
만화는 AI로 제작한 비유이며, 별도 표시가 없는 수치는 가상 예시입니다.
Comments (0)