— views
AI 입문 11화. 연습문제만 외우면 실력이 좋아질까? — 과적합
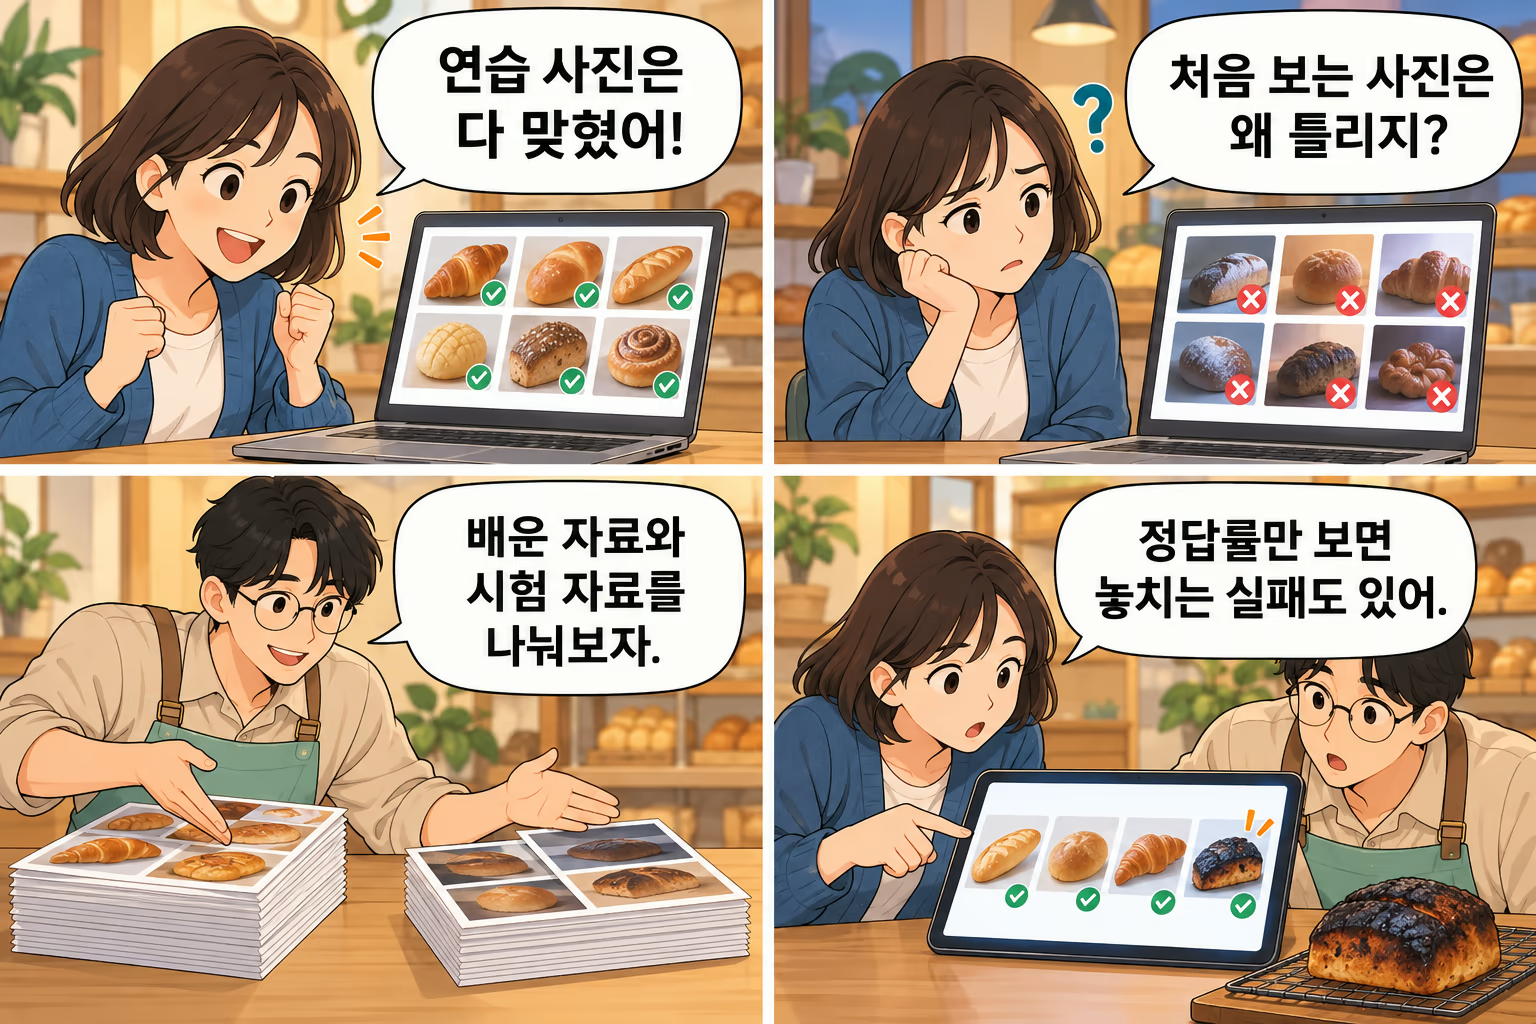
연습 사진 100장은 모두 맞히던 모델이 새로 찍은 빵 사진에서는 계속 틀립니다. 점수는 좋았는데 실력이 부족한 이유는 무엇일까요?
학습 자료에 지나치게 맞출 수 있습니다
과적합은 특정 촬영 배경이나 잡음처럼 훈련 자료에만 있던 특징까지 익혀 새 자료에서 성능이 떨어지는 현상입니다.
반대로 모델이 너무 단순하거나 충분히 학습하지 못해 연습 자료도 잘 설명하지 못하면 과소적합을 의심할 수 있습니다. 무조건 오래 학습하거나 크게 만드는 것만이 해결책은 아닙니다.
연습·조정·최종 시험을 나눕니다
훈련 자료는 모델 학습에 사용합니다. 검증 자료는 설정을 비교하고 학습을 언제 멈출지 판단하는 데 사용합니다. 시험 자료는 선택 과정에서 충분히 분리해 최종 성능을 확인하는 데 둡니다.
시험 점수를 보고 계속 설정을 고치면 시험 자료가 사실상 검증 자료가 됩니다. 같은 고객이나 같은 사진의 복제본이 여러 묶음에 섞이는 문제도 주의해야 합니다.
실제 사용할 조건을 대표해야 합니다
내일 판매를 예측하는 모델이라면 과거로 학습해 미래를 평가하는 시간 순서가 중요할 수 있습니다. 사진 분류라면 다른 조명·각도·기종을 포함해야 합니다. 무작위로 나누는 한 가지 방식이 언제나 충분하지는 않습니다.
자료를 더 다양하게 모으거나 모델의 복잡도를 조정하고 정규화·조기 종료 등을 사용할 수 있습니다. 먼저 실패가 어떤 상황에 몰리는지 확인한 뒤 원인에 맞는 방법을 선택합니다.
좋은 연습 점수 뒤에 숨은 조건을 찾기
밝은 촬영대에서만 연습한 모델이 매장에서 틀린다면, 같은 제품의 조명을 바꿔 시험하세요. 새 제품 때문인지 조명 때문인지 구분할 수 있습니다.
한눈에 정리하기
자료 | 역할 | 주의 |
|---|---|---|
훈련 | 모델 조정 | 대표성·오염 |
검증 | 설정 선택 | 반복 선택 편향 |
시험 | 최종 평가 | 선택 과정에 유출하지 않기 |
시험 점수가 낮은 이유는 과적합 외에 데이터 분포 변화나 평가 오류일 수도 있습니다.
확인 문제
같은 사진의 복사본이 학습용과 시험용에 한 장씩 있다. 새 사진을 얼마나 잘 맞히는지 평가하려면?
① 복사본을 같은 묶음에 넣어 분할한다
② 두 복사본의 파일 이름만 다르게 바꾼다
정답과 해설
정답 ① 복사본을 같은 묶음에 넣어 분할한다 · 모델이 이미 본 이미지를 시험에서 다시 만나면 점수가 부풀 수 있다. 파일 이름을 바꿔도 이미지 내용은 같다.
조금 더 깊이 · 선택해서 읽기
일반화는 학습 자료 밖의 관련 사례에도 성능이 이어지는 성질입니다. 모든 미래 상황을 보장하는 말은 아니며 평가 분포와 적용 범위를 함께 밝혀야 합니다.
함께 볼 위키
출처와 더 읽을 자료
Google — Overfitting — 새 데이터 일반화와 과적합 · 확인 2026-10-29
Google — Working with numerical data — 데이터 준비와 수치 특징 · 확인 2026-10-29
만화는 AI로 제작한 비유이며, 별도 표시가 없는 수치는 가상 예시입니다.
Comments (0)