— views
AI 입문 34화. 어떤 답이 더 나을까? — 사람의 선호를 반영하는 학습
같은 질문에 답변 두 개가 나왔습니다. 하나는 길지만 질문을 놓쳤고, 다른 하나는 짧고 정확하게 도움을 줍니다. 어떤 답변을 더 선호하는지 비교한 자료도 학습에 활용할 수 있습니다.
좋은 답변 하나와 답변 비교는 다른 자료입니다
SFT는 바람직한 답변을 예시로 주고, 선호 학습은 여러 답변 중 어떤 것을 더 좋게 보았는지 알려 줍니다.
사람의 평가 기준은 친절함·도움·지시 준수·안전성 등 여러 요소를 포함할 수 있습니다. 평가자를 어떻게 선정하고 어떤 기준을 제시하는지에 따라 선호 자료의 성격도 달라집니다.
대표적인 RLHF는 보상 모델을 이용합니다
고전적인 RLHF 흐름의 한 예에서는 사람들이 비교한 자료로 응답에 점수를 주는 보상 모델을 학습합니다. 이어 언어 모델이 높은 보상을 얻도록 강화학습으로 조정합니다. 보통 앞서 SFT를 수행하는 등 여러 단계로 구성합니다.
보상 모델은 사람의 선호를 근사하는 또 다른 모델입니다. 높은 점수가 사실의 절대적인 판정표는 아닙니다. 점수만 잘 얻는 표현이나 평가 기준의 빈틈을 배우는 문제를 살펴야 합니다.
DPO는 다른 학습 경로를 사용합니다
DPO는 선호하는 응답과 덜 선호하는 응답의 비교 자료를 이용해 언어 모델을 직접 최적화하는 방법입니다. 대표적인 DPO에서는 별도의 보상 모델을 학습하고 강화학습 루프를 돌리는 단계를 요구하지 않습니다.
목적이 비슷하다고 모든 선호 학습을 동일한 RLHF 절차로 설명하면 혼동이 생깁니다. 실제 모델의 후속 학습은 여러 방법을 섞을 수 있으므로 공개된 설명 범위 안에서 말해야 합니다.
마음에 든 답변도 근거는 따로 확인합니다
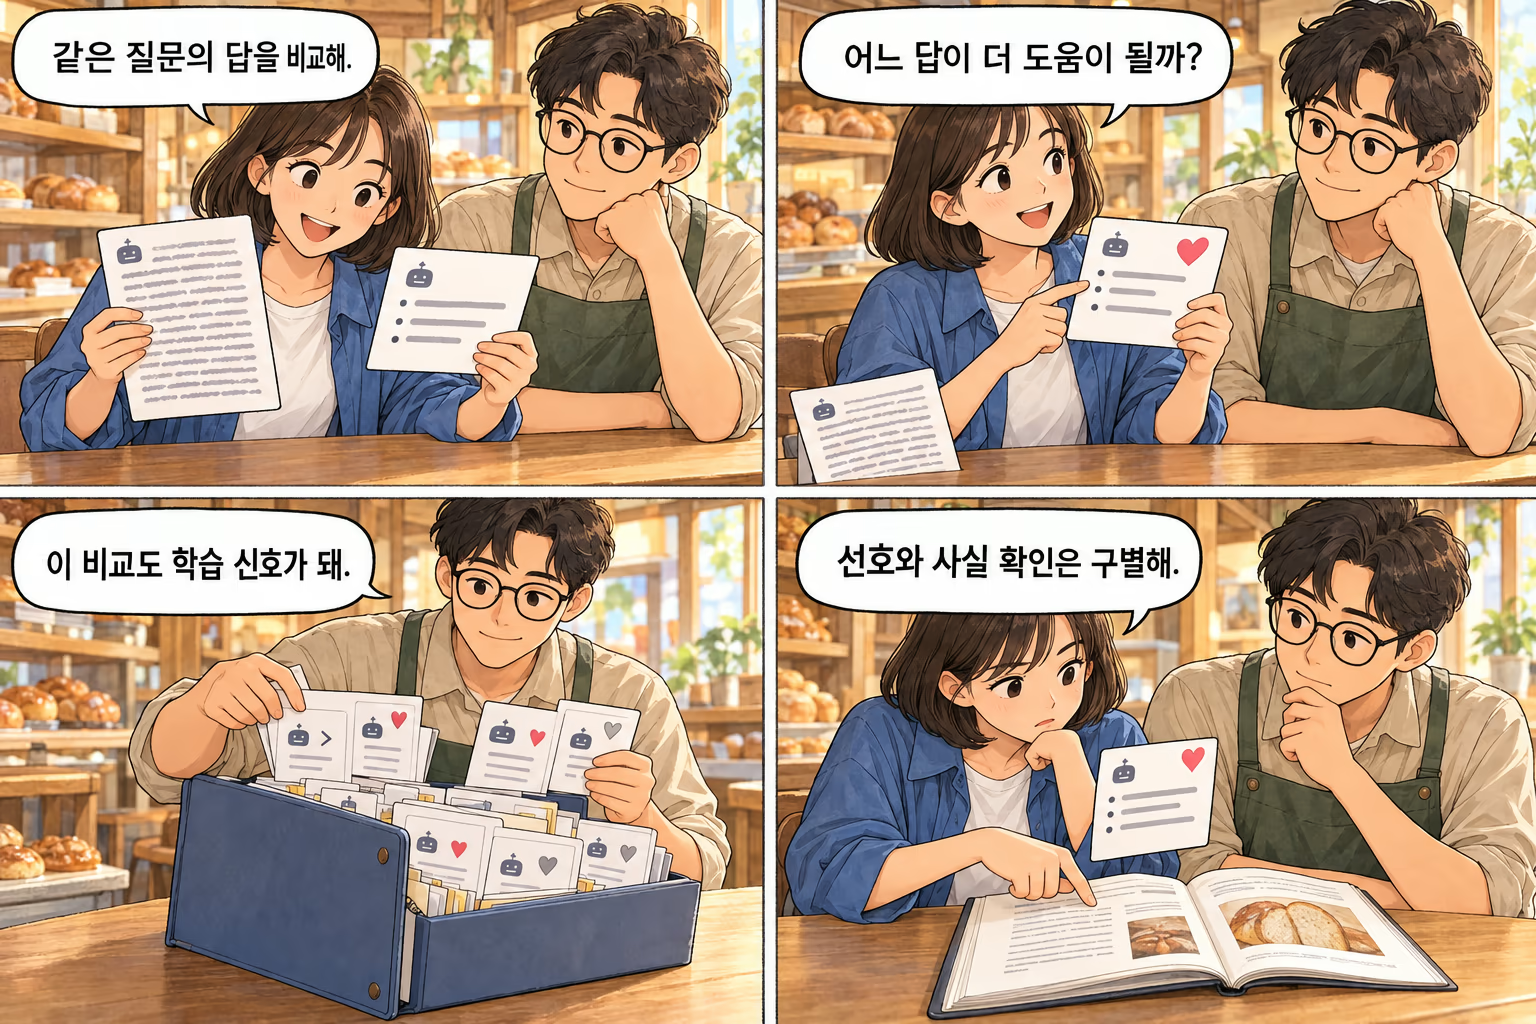
읽기 쉬운 답변을 고른 기록은 선호 자료입니다. 그 답에 적힌 행사 날짜가 맞는지는 공지와 대조해야 합니다.
한눈에 정리하기
방법 | 대표적인 학습 자료와 경로 |
|---|---|
SFT | 좋은 응답 예시 → 지도 학습 |
고전적 RLHF 예 | 응답 비교 → 보상 모델 → 강화학습 |
DPO | 응답 비교 → 선호 목적함수로 직접 최적화 |
공통 확인점 | 선호 점수와 실제 품질의 차이 |
조금 더 깊이 · 선택해서 읽기
RLHF라는 말을 넓게 쓰는 문헌과 특정 강화학습 절차를 뜻하는 문헌이 있습니다. 이 글은 보상 모델을 사용하는 대표적인 RLHF 사례와 DPO를 구별해 설명합니다. 특정 제품의 비공개 학습 방법을 추정하지 않습니다.
함께 볼 위키
출처와 더 읽을 자료
Ouyang 외 — Training language models to follow instructions with human feedback (2022) — SFT·사람의 응답 비교·RLHF · 확인 2026-10-29
Rafailov 외 — Direct Preference Optimization (2023) — 선호 자료를 통한 직접 최적화 · 확인 2026-10-29
만화는 AI로 제작한 비유이며, 별도 표시가 없는 수치는 가상 예시입니다.
Comments (0)