— views
AI 입문 36화. 답변은 왜 한 조각씩 나올까? — 실제 추론 과정
긴 자료를 붙이면 답변을 시작하기까지 기다리게 되고, 답변이 시작된 뒤에는 글자가 차례로 나타납니다.
프리필은 주어진 입력을 처리합니다
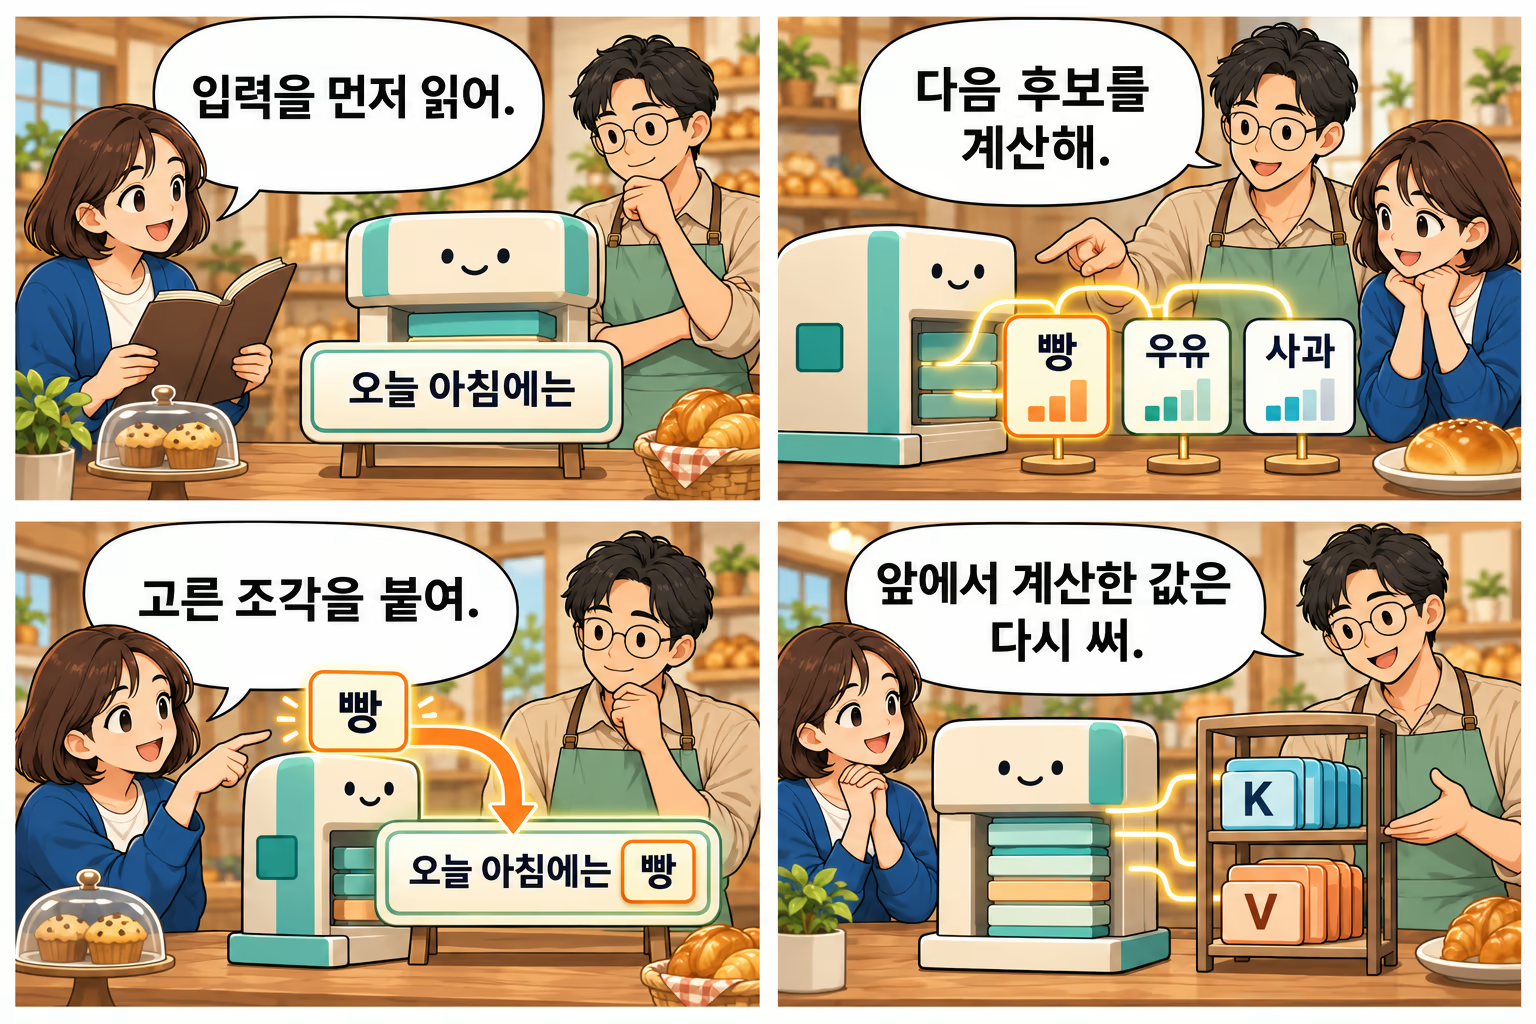
프리필은 이미 주어진 입력 토큰들을 처리하는 단계입니다. 대표적인 인과적 트랜스포머에서도 마스크를 지키면서 여러 입력 위치를 함께 계산할 수 있습니다. 마지막 위치 출력에서 다음 토큰을 선택할 준비를 합니다.
입력 길이가 길면 처리할 양과 메모리 요구가 늘어날 수 있습니다. 실제 대기 시간에는 모델 계산뿐 아니라 서버 대기·통신·검색·도구 실행 등도 영향을 줍니다.
디코딩은 생성한 토큰을 이어갑니다
다음 토큰 하나를 선택한 뒤에는 그 토큰을 추가해 다음 출력을 계산하는 과정이 이어집니다. 일반적인 자기회귀 생성에서는 아직 선택되지 않은 미래 토큰을 입력으로 미리 넣을 수 없으므로 반복 사이에 의존성이 있습니다.
이 때문에 학습에서 여러 위치를 병렬로 계산할 수 있다는 말과 답변 전체를 같은 방식으로 한꺼번에 생성한다는 말은 다릅니다. 실제 구현에는 추측 디코딩 등 속도를 높이는 변형도 있습니다.
KV 캐시는 앞부분의 계산 결과를 재사용합니다
표준 인과적 어텐션에서는 새 토큰을 뒤에 붙여도 앞선 위치의 키·값은 바뀌지 않습니다. 그래서 층별 K·V를 다시 쓸 수 있습니다.
새 토큰은 자신의 표현을 계산하면서 저장된 K·V를 참고하고 새 K·V를 더합니다. 캐시는 모델의 가중치와 다른 일시적인 실행 상태입니다. 대화 내용을 학습해 영구 지식으로 바꾸는 기능은 아닙니다.
빠르게 만드는 대신 저장 공간이 필요합니다
문맥이 길어지면 KV 캐시가 사용하는 메모리도 커질 수 있습니다. 길이·배치 크기·층 수·표현 방식 등 여러 요소가 영향을 줍니다. 캐시를 압축하거나 옮기는 전략에는 속도와 메모리의 절충이 있습니다.
서로 다른 요청에 캐시를 무조건 붙여 쓸 수는 없습니다. 입력 앞부분과 모델·설정 등 재사용 조건이 맞아야 합니다. 캐시 사용 여부와 서비스의 대화 보관 정책도 다른 문제입니다.
답변의 첫 조각 전후에 하는 일이 달라집니다
긴 입력을 처음 처리하는 단계가 프리필입니다. 이후 토큰을 하나씩 만들 때 KV 캐시는 앞선 위치의 키·값을 재사용합니다.
한눈에 정리하기
구분 | 처리 내용 | 가중치 학습인가요? |
|---|---|---|
프리필 | 주어진 입력을 계산 | 일반 추론에서는 아니요 |
디코딩 | 출력 토큰을 선택하며 반복 | 일반 추론에서는 아니요 |
KV 캐시 | 이전 키·값을 저장해 재사용 | 아니요 |
별도 미세조정 | 학습 절차로 매개변수 조정 | 예 |
KV 캐시와 계정의 대화 기록은 별도입니다. 하나를 지워도 다른 하나를 지웠다는 뜻은 아닙니다.
확인 문제
답변을 한 토큰 더 생성할 때 앞선 토큰의 키와 값을 다시 쓰는 것은?
① 지도 미세조정
② KV 캐시
정답과 해설
정답 ② KV 캐시 · 캐시는 이번 추론에서 이미 계산한 값을 보관한다. 그 값을 재사용해도 가중치는 갱신되지 않는다.
조금 더 깊이 · 선택해서 읽기
캐시는 보통 과거의 K·V를 저장합니다. 새 위치의 Q는 현재 계산에 필요하며 과거 Q를 같은 목적으로 계속 저장할 필요는 없습니다. 구체적인 캐시 배치와 수치 정밀도는 구현에 따라 다릅니다.
함께 볼 위키
출처와 더 읽을 자료
Hugging Face — How caching works — 이전 K·V 재사용과 인과적 계산 · 확인 2026-10-29
Hugging Face — Text generation — 자기회귀 생성 흐름 · 확인 2026-10-29
만화는 AI로 제작한 비유이며, 별도 표시가 없는 수치는 가상 예시입니다.
Comments (0)